RAG простыми словами: как ИИ отвечает по документам компании и как подготовить базу знаний
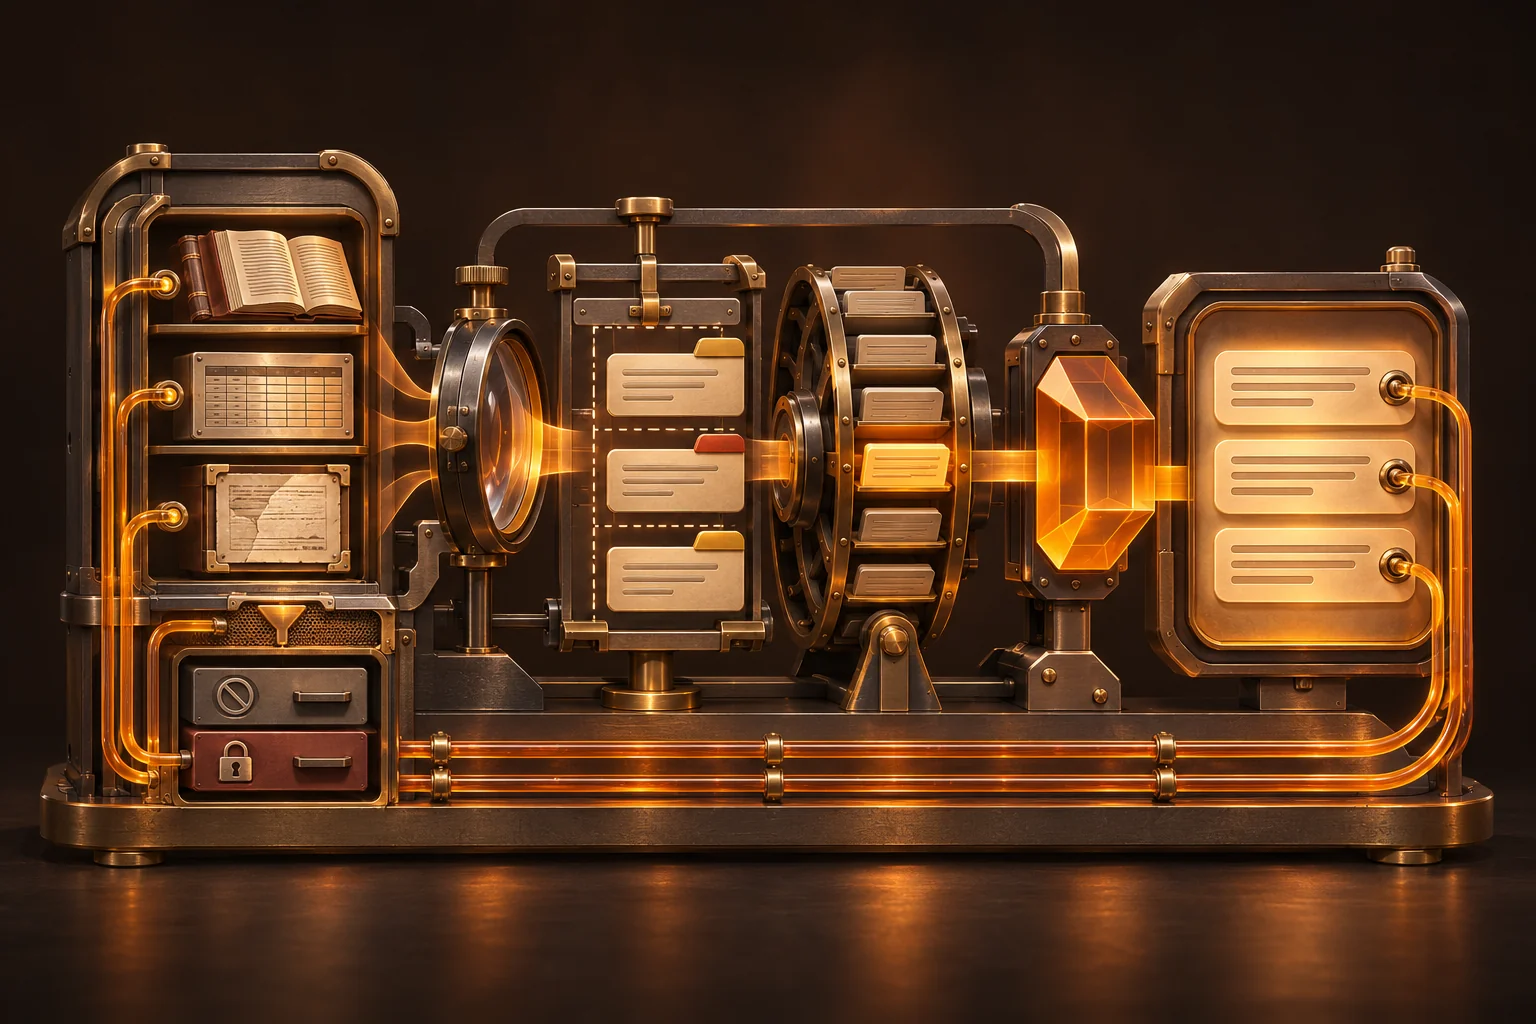
Короткий ответ: RAG — это когда ИИ перед ответом сначала ищет нужные места в ваших документах, а потом формулирует ответ только по найденному. Модель не «знает» ваш прайс — она его каждый раз читает. Поэтому качество такого ассистента в первую очередь зависит не от модели, а от базы знаний: какие документы в ней лежат, нет ли дублей и старых версий и кто её обновляет. Ниже — механика без жаргона и чек-лист подготовки документов.
Термин RAG (Retrieval-Augmented Generation, «генерация с опорой на найденное») появился в 2020 году в научной статье Lewis и соавторов. С тех пор так устроены многие ассистенты, которые отвечают по данным конкретной компании: чат-боты на сайте, помощники для сотрудников, поиск по архиву документов. Разбираем, что происходит внутри и что от вас потребуется до запуска.
Что такое RAG простыми словами?
Представьте нового сотрудника на телефоне, которому разрешено отвечать только по папке с документами. Звонит клиент — сотрудник находит нужную страницу, читает её и пересказывает своими словами. RAG делает то же: поиск находит фрагменты, языковая модель пишет по ним ответ.
По шагам это выглядит так:
- Вопрос. Клиент пишет: «Сколько стоит доставка в Подольск и можно ли оплатить при получении?»
- Поиск. Система ищет в базе знаний фрагменты, близкие по смыслу: раздел про зоны доставки и раздел про способы оплаты. Ищет не по точному совпадению слов, а по смыслу — поэтому «оплата курьеру» найдётся и на запрос «можно ли заплатить при получении».
- Подсказка модели. В модель уходит вопрос, найденные фрагменты и правила: отвечай только по этим материалам, не знаешь — так и скажи.
- Ответ. Модель формулирует ответ и, если так настроено, ставит ссылку на документ, из которого взяты сведения.
Ключевое отличие от обычного чата с ИИ: без RAG модель отвечает «по памяти» — по тому, на чём её обучили. Ваших цен, условий и регламентов там нет, и модель их правдоподобно додумывает. С RAG у неё перед глазами ваш текст, и проверить ответ можно по первоисточнику.
Чем RAG отличается от дообучения модели?
Дообучение меняет саму модель: её долго тренируют на ваших примерах, и знания «впитываются» внутрь. RAG модель не трогает — он каждый раз подкладывает ей нужные страницы. Для фактов, которые меняются (цены, сроки, правила), почти всегда подходит RAG; дообучение нужно для стиля и формата.
Частая просьба заказчика звучит так: «обучите ИИ на наших документах». Под этим обычно имеется в виду именно RAG, а не дообучение в техническом смысле. Разница важна для бюджета и для того, как вы потом будете жить с системой:
- Цены поменялись в понедельник. С RAG вы заменяете файл прайса, база переиндексируется, и с этого момента ассистент отвечает по новым ценам. С дообученной моделью старые цены остаются внутри, пока её не переучат.
- Нужно доказать, откуда ответ. RAG показывает документ и фрагмент. Дообученная модель сослаться на источник не может — она просто «так думает».
- Нужно убрать сведения. Документ, который нельзя больше показывать, из базы удаляется за минуту. Вытащить конкретный факт из обученной модели — отдельная и ненадёжная задача.
Дообучение оправдано, когда нужно научить модель писать в определённом формате — например, всегда в виде заключения из трёх блоков — или понимать узкую терминологию отрасли. Для ассистента, который отвечает клиентам и сотрудникам по документам компании, оно обычно не нужно, а иногда и мешает: знания устаревают внутри модели.
| Вопрос | RAG (поиск по базе знаний) | Дообучение модели |
|---|---|---|
| Что меняется | К вопросу добавляются найденные фрагменты ваших документов | Меняются внутренние веса модели |
| Новый прайс или регламент | Заменили файл — ответы обновились после переиндексации | Нужен новый цикл обучения |
| Ссылка на источник | Можно показать документ и фрагмент, откуда взят ответ | Источник не показать: знание «растворено» в модели |
| Удалить сведения | Убрали документ из базы — модель перестала на него опираться | Удалить конкретный факт из модели сложно |
| Для чего подходит | Факты, цены, правила, инструкции, условия договоров | Стиль, формат ответа, узкая терминология |
Как документы превращаются в базу для поиска?
Документы разбирают на фрагменты по смыслу — разделы, пункты, абзацы, — каждому фрагменту сохраняют источник и дату, затем строят поисковый индекс по смыслу текста. Когда документ меняется, его фрагменты пересчитываются. Это и есть «база знаний», которую видно и можно править.
Что происходит с файлами на этом этапе:
- Извлечение текста. Из PDF, Word, страниц сайта и таблиц достаётся текст. Сканы и фото сначала распознаются — без этого для поиска их не существует.
- Нарезка на фрагменты. Документ на сорок страниц бесполезно отдавать модели целиком: ей нужен конкретный пункт. Режут по структуре — главам, пунктам, вопросам FAQ, — чтобы фрагмент был законченной мыслью. Плохая нарезка — частая причина ответов «мимо»: условие оказалось в одном фрагменте, а исключение из него — в другом.
- Метки. К фрагменту привязывают название документа, раздел, дату редакции, иногда — для кого он (клиенты или только сотрудники). По меткам потом фильтруют: старые редакции не участвуют в поиске, внутренние документы не попадают в ответы клиентам.
- Индекс по смыслу. Каждый фрагмент переводится в числовое представление смысла, чтобы похожие по содержанию тексты находились рядом, даже если слова разные. Часто его дополняют обычным поиском по словам — так надёжнее находятся артикулы, номера пунктов и названия.
Хороший пример того, как далеко можно довести этот этап, — наш проект «Довод», ИИ-ассистент для юристов. Его база — 11 658 статей кодексов и федеральных законов и 495 постановлений Пленумов, разобранных на 9 392 пункта. Каждая статья хранится по редакциям, законы обновляются ночью, практика — по воскресеньям. А если в черновике ответа появилась ссылка на норму, которую ассистент не открывал в базе, сервер такую сноску выбрасывает: в ответе остаются только проверяемые ссылки.
Какие документы подходят, а какие мешают?
Подходят актуальные документы с ясной структурой, написанные для того, кто спрашивает: регламенты, FAQ, условия, инструкции, прайсы с заголовками. Мешают дубли, старые редакции, переписка и черновики, таблицы без шапок и сканы без распознавания. Мусор в базе превращается в уверенные неправильные ответы.
Почему дубли и старые версии опаснее, чем кажется. Поиск не знает, какой файл «правильный», — он находит самые похожие на вопрос фрагменты. Если в общей папке лежат «Договор поставки», «Договор поставки (новый)» и «Договор поставки финал 2», ассистент может взять срок оплаты из одного, а неустойку — из другого. Ответ получится гладким и при этом не будет соответствовать ни одной редакции. Сотрудник такую ошибку заметит не сразу, клиент — не заметит вовсе.
Таблицы — отдельная история. Прайс в Excel, где первая строка — название компании, вторая пустая, а цены идут с пятой строки без подписей столбцов, для поиска превращается в набор чисел. Модели нужно видеть, что «4 500» — это цена за штуку для партии от 12 штук. Если прайс живёт в учётной системе, его надёжнее подтягивать оттуда выгрузкой, чем вручную копировать файл.
Переписку и чаты в базу не кладут. В них правила перемешаны с исключениями «для этого клиента», мнениями и шутками. Если из переписки нужно что-то сохранить, правило выписывают отдельным коротким документом.
| Материал | Что с ним делать | Почему |
|---|---|---|
| Действующие регламенты, FAQ, условия доставки и возврата | Отдать как есть, указать дату редакции | Короткие ясные ответы на частые вопросы |
| Прайс в таблице | Отдать таблицей с заголовками столбцов или выгрузкой из учётной системы | Без шапки строка «12 / 4 500 / шт» теряет смысл |
| Три версии одного договора | Оставить одну действующую, старые убрать или пометить архивом | Поиск найдёт все три, и ответ смешает редакции |
| Сканы и фото документов | Распознать, проверить цифры, сохранить текстом | Картинку без текста поиск не видит |
| Переписка и черновики | Не загружать, выписать из неё правила отдельным документом | Мнения сотрудников станут «официальным» ответом |
| Документы с персональными данными | Не загружать или обезличить | Ассистент может процитировать их постороннему |
Как подготовить базу знаний?
Начните не с документов, а с вопросов: соберите 30–50 реальных вопросов клиентов или сотрудников, затем найдите для каждого документ с ответом. Чего нет — допишите, что устарело — уберите. На этих же вопросах потом проверяют ассистента перед запуском.
Чек-лист подготовки, который экономит время на брифе и прототипе:
- Соберите вопросы. Из почты, чата поддержки, CRM, у менеджеров на первой линии. Вопросы в формулировках клиентов, с ошибками и сокращениями, — ассистент будет получать именно такие.
- Найдите ответ на каждый. Отметьте, в каком документе и в каком пункте он лежит. Вопросы без ответа в документах — это пробелы, которые надо закрыть до запуска, иначе ассистент будет их честно передавать оператору.
- Уберите дубли. На каждую тему — один действующий документ. Старые редакции удалите из выгрузки или сложите в архив, который в поиске не участвует.
- Проставьте даты и владельцев. У каждого документа — дата редакции и человек, который за него отвечает. Без владельца документ устаревает незаметно.
- Разделите внешнее и внутреннее. Что можно показывать клиентам, а что только сотрудникам. Одна база с разграничением или две отдельные — решается на брифе.
- Проверьте персональные данные. Договоры с ФИО, паспортами и телефонами клиентов в базу не загружают или обезличивают. Если ассистент работает с персональными данными, вопрос о том, где обрабатывается запрос и куда он уходит, решается до разработки — подробно в статье «Можно ли отправлять персональные данные клиентов в облачный ИИ-сервис» и в тексте 152-ФЗ на consultant.ru.
- Подготовьте таблицы и сканы. У таблиц — шапка в первой строке, одна таблица на лист, без объединённых ячеек. Сканы — распознать и выборочно сверить цифры с оригиналом.
Базе знаний для сайта небольшой компании бывает достаточно нескольких десятков страниц текста. Объём здесь не цель: десять точных страниц полезнее тысячи файлов из общей папки «как есть».
Кто обновляет базу после запуска?
Обновляет её ваш сотрудник, а не разработчик: загрузил новую редакцию, убрал старую, проверил пару вопросов. У каждого раздела должен быть владелец — тот, кто и так отвечает за этот документ в компании. Без этого через три месяца ассистент уверенно отвечает по прошлогоднему прайсу.
Как это устроено на практике:
- Панель базы знаний. В нашем тарифе ассистента вы получаете доступ к панели и базе знаний и инструкцию, как её обновлять и смотреть диалоги. Убрали документ — ассистент перестал на него опираться.
- Автоматическое обновление. Если источник живёт в другой системе — страницы сайта, учётная система, база правовых актов, как в «Доводе», — обновление настраивают по расписанию. Это дороже на старте, но снимает ручной труд.
- Журнал вопросов без ответа. Раз в неделю владелец базы смотрит, о чём спрашивали, а ассистент передал оператору. Это прямой список документов, которые нужно дописать.
- Контрольные вопросы. Те же 30–50 вопросов с подготовки прогоняют после крупных изменений базы: не сломалось ли то, что работало.
Сколько это стоит. Тариф «AI-решения / AI-ассистенты» в прайсе — от 72 000 ₽ и от 3 дней: чат-бот на ваших данных, загрузка и структурирование базы знаний с обновлением, ограничение ответов рамками темы, виджет на сайт и один мессенджер, связка с CRM, передача разговора живому оператору. Работа языковой модели оплачивается отдельно, по факту, на ваш аккаунт. До 2 раундов правок, 7 дней бесплатной поддержки после запуска, затем сопровождение по абонентской плате — поддержка от 7 900 ₽ в месяц. По типовому договору — оплата 50/50 и гарантия 30 календарных дней с даты акта. Если базу нужно автоматически подтягивать из 1С или складской системы, это отдельная работа по тарифу «Интеграции и автоматизация» — от 32 000 ₽. Подробно о составе — на странице ИИ-ассистента для бизнеса.
Когда RAG не нужен
RAG не нужен, если ответов мало и они не меняются — хватит кнопочного бота или страницы FAQ. Он не подходит для точных расчётов и данных, которые надо считать, а не искать. И он не спасёт, если документов с ответами в компании просто нет.
Типичные случаи, когда деньги разумнее потратить иначе:
- Десять вопросов на всё. Если клиенты спрашивают про часы работы, адрес, доставку и оплату, сценарный бот с кнопками дешевле и предсказуемее. Сравнение — в статье «Чат-бот для сайта: кнопочный или с ИИ».
- Нужны цифры из учёта. «Какая выручка по филиалу за сентябрь» — это не поиск по документам, а запрос к базе данных. Для таких вопросов делают другой механизм: вопрос обычными словами превращается в запрос к вашим данным, а результат считает система, а не модель.
- Нужно выполнять действия. Создать сделку, поставить задачу, отправить счёт — это уже ИИ-агент с подтверждением человеком, а не ассистент по документам.
- Знания живут в головах. Если регламентов нет, а правила знает один опытный менеджер, сначала их придётся записать. Это работа компании, а не разработчика, и без неё ассистент будет отвечать «не знаю» на половину вопросов.
- Ошибка недопустима, а проверять некому. Медицинские назначения, юридически значимые решения, расчёты денег — здесь ассистент может готовить черновик со ссылками на источник, но финальное решение остаётся за человеком.
Ошибки, которые мы чаще всего видим на старте: загрузить всю общую папку без отбора; не назначить владельца базы; проверять ассистента на придуманных, а не на реальных вопросах; ждать, что модель сама поймёт, какая редакция договора действующая. Все четыре решаются на этапе подготовки базы — до того, как ассистентом начнут пользоваться клиенты.
Короткие ответы на частые вопросы
RAG — это отдельная программа или функция ИИ?
Это способ устройства системы, а не отдельный продукт: перед ответом программа ищет подходящие фрагменты в ваших документах и передаёт их языковой модели вместе с вопросом. Поиск, база знаний и правила вокруг модели пишутся под задачу.
Может ли ассистент на RAG всё равно ошибиться?
Может: если нужного документа нет в базе, если в ней лежат две противоречащие редакции или если поиск достал не тот фрагмент. Поэтому ответы ограничивают рамками темы, показывают источник и передают сложные вопросы живому оператору.
Сколько документов нужно, чтобы начать?
Минимального порога нет: ассистент для частых вопросов клиентов работает и на десятке хорошо написанных страниц. Важнее не объём, а то, что каждая страница актуальна и отвечает на реальные вопросы.
Можно ли загрузить в базу Excel и сканы?
Можно, но их готовят: у таблиц должны быть понятные заголовки столбцов, а сканы распознают в текст и проверяют цифры. Без этого поиск либо не найдёт данные, либо найдёт их без смысла.
Сколько стоит ассистент с базой знаний и сколько платить потом?
В нашем прайсе тариф «AI-решения / AI-ассистенты» — от 72 000 ₽ и от 3 дней, загрузка и структурирование материалов входят. Работа языковой модели оплачивается отдельно, по факту, на ваш аккаунт; после 7 дней бесплатной поддержки — абонентская плата.
Услуги и кейсы по теме: поддержка сайта от 7 900 ₽/мес · ИИ-ассистент на ваших данных от 72 000 ₽ · кейс «Довод» · цены и сроки
Пришлите список документов, по которым должен отвечать ассистент, и десяток реальных вопросов клиентов или сотрудников — скажем, что из этого годится для базы знаний, что нужно почистить, и назовём цену после брифа.
Рассчитать проект →Оценку срока и цены по брифу делаем бесплатно, обычно отвечаем в течение часа в рабочее время. Типовой договор — посмотреть до оплаты.